sentinelK
V2EX  ›  Local LLM

strata 极致优化指南(参数篇)64GB RAM + RTX pro 5000 48GB, IQ3_XXS 量化, prefill 4500t/s, decode 180t/s 同时缓存 5 个 262k 会话不重新 prefill

  •  
  •   sentinelK · 1 day ago · 1278 views

    前言:strata 最近已经火出圈了,火到 RAM 又翻了个倍。目前京东自营,海力士颗粒的 64GB 的 DDR5 6000 内存已经几近破万。

    十一长假回来,笔者也是暂时小试牛刀了一把,发现有一些关键参数,会直接影响整个 LLM 引擎的本质体验,但是默认值并不是特别合理。所以发个 tips 小文供大家交流。欢迎批评指正。

    本文全程手打,无任何 AI 含量,请放心阅读。 image.jpeg

    1 、Harness 会频繁唤起子代理( sub agent ),导致切换会话 prefill 浪费太多时间,怎么办?

    答:开启--conversation-cache-mib

    这个参数会让 strata 使用 RAM 来缓存历史对话,从而不让 LLM 反复重新 prefill 老的 session 。增加会话切换时的速度,对于 agent 、harness 场景有奇效。

    开启 conversation-cache-mib 后,monitor 面板会有如下展示: image.jpeg
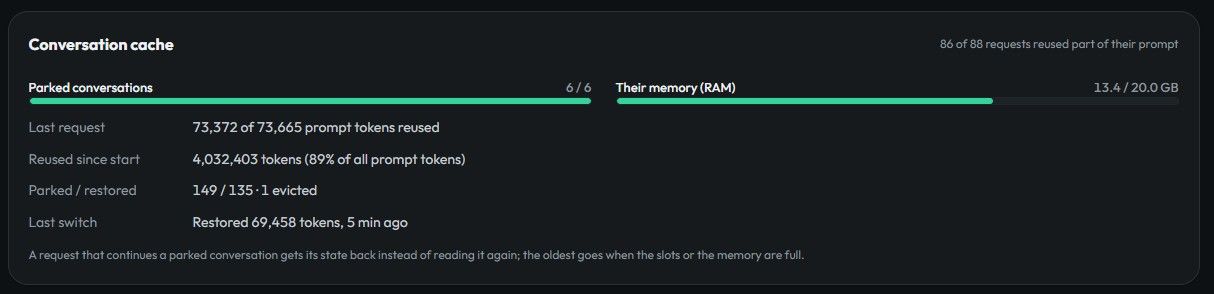
    分别表述当期缓存了多少个会话,以及目前占用了多少 RAM 。

    这个机制有个痛点:不支持多显卡。


    2 、我的显卡显存总是占不满,浪费一些,怎么破?

    答:配置--expert-cache ,不要用 auto 档位。手动指定

    让更多的专家进驻显存。注意,手动指定的是下限,所以要反复测试量力而行。


    3 、我想使用上文的 conversation-cache ,但是我 RAM 都快满了,怎么办?

    答:启用低内存模式:--resident-experts

    小科普,正常默认情况下,strata 加载的专家是内存+SSD 加载全量,vRAM 加载高命中概率专家。相当于 RAM 和 vRAM 之间,是有一定的重复加载的。

    官方这样指定默认值是有道理的,一旦 VRAM 的专家没能命中,直接可以读取 RAM 的进入 vRAM 。 代价就是这会导致 RAM 的极大浪费。

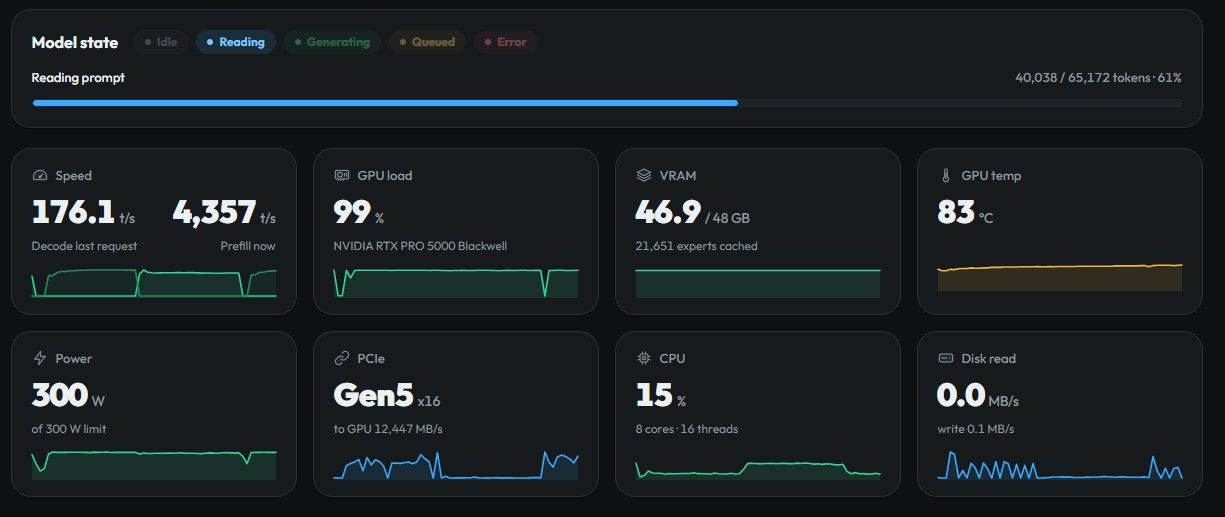
    通过配置低内存模式,能够让 vRAM+RAM 分别加载不同专家,分工合作。这样能节省巨量 RAM 。代价是一旦 VRAM 中的专家没能命中,除了从 RAM 读取以外,还要从 vRAM 剔除一个回写到 RAM 。但相较于直接节省 40GB 的 RAM 空间而言,这点回写简直可以忽略不计。而且你显卡的显存越大,遇到回写的概率越低。 笔者的是 48GB 的 rtx pro 5000 ,专家命中率一直保持在 99%。


    4 、我想多个聊天会话一起聊(并发),怎么办? 答,配置 parallel: X ( X 是并发会话数,最大 8 )

    会占用显存,我个人实测,IQ3_XXS 量化下,会话长度 262k ,每个并发占用 5.2GB 显存。

    以上,欢迎列位交流,指正。最后列出我个人的全套参数,供各位参考。

    "args": [
      "--pack", "C:\\work\\Strata-data\\packs\\iq3_xxs",
      "--native", "C:\\work\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00001-of-00002.gguf",
      "--ple-gguf", "C:\\work\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00002-of-00002.gguf",
      "--expert-profile", "C:\\work\\Strata\\data\\expert-profile.bin",
      "--resident-experts",
      "--expert-cache", "19000",
      "--prefill", "auto",
      "--spec", "4",
      "--mtp", "C:\\work\\Strata-data\\mtp\\rt",
      "--max-context", "262144",
      "--kv", "k8v4",
      "--vision", 
      "--vram-reserve-mib", "3400", 
      "--pcie-frac", "0.00", 
      "--spec-min-p", "0.70",
      "--conversation-cache-mib", "27648",
      "--conversation-cache-slots", "9",
      "--conversation-cache-min-free-mib", "8192",
      "--prompt-cache-every", "8192"
     ],
    
    8 replies  •  2026-10-09 23:57:35 +08:00
    sentinelK
        1
    sentinelK  
    OP
       1 day ago
    经此配置后,strata + qwen3.8-flash-next IQ3 这套组合,在驱动 harness 这个领域,除了并发效率以外,已经完美吊打 sglang+qwen3.8-27B-nvfp4 这套传统的全量显存组合。

    首先,strata 因为基于 llama.cpp ,所以不存在 memba 层和 kvcache 层的抉择问题。
    其次,IQ3_XXS 的 qwen3.8-flash-next ,模型能力本身超过 qwen3.8-27B-nvfp4 。
    最后,无论是 prefill 的稳定度还是 decode 速度,strata 这套混合架构+MOE 模型,均超越了 27B 稠密模型的性能表现。
    jinsongzhaocn
        2
    jinsongzhaocn  
       1 day ago
    用 zx-bench 这种工具测试一下编程和 CLI 工具调用两个指标看看? strata 技术初衷是缓解 Q4 以下的量化精度暴跌问题,按理说一定超不过 Q4 量化模型,难道靠 flash_next 的 125b 超越 27b ,纯靠知识量弥补精度?最多也就是 IQ3_S 有点希望
    hanguofu
        3
    hanguofu  
       1 day ago via Android
    谢谢分享!请问楼主用的是什么主板和 CPU ?
    sentinelK
        4
    sentinelK  
    OP
       20h 52m ago
    @jinsongzhaocn 按照官方“吹”的原话,是 IQ3_S 和全量几乎一致。IQ3_XXS 大概是 98.x%的一致性。

    我的理解一致性比例相同理论上讲能力趋势也应该相同。
    https://artificialanalysis.ai/ 上 qwen3.8-flash 是 40 分,27B 稠密是 34 分。

    那么理论上讲一致性和困惑度与 3.8-flash-IQ3_XXS 相近的 27B-nvfp4 也应该遵循这个能力差距。至少应该不会逆转。

    我个人是这么肤浅的理解。
    coefu
        5
    coefu  
       19h 26m ago
    量化之后的能力,是看往哪边侧重的使用了。量化也只能往某种方向保留原本能力,舍弃部分别的能力。

    IQ3_XXS 主要是保 stem 这一块的综合能力,主要是在 AIME ,GPQA-D 这两个核心 benchmark 和 BF16 对齐,这一块的能力实际上就是大家能感受到的所谓的 智能密度。

    其实主要还是 GPQA-D ,90 分是一个分水岭,90 分之后每提升 1 分,都能指导前一个阶段的工作,发现前一个阶段留的 bug 。
    coefu
        6
    coefu  
       19h 24m ago
    你这个资源,可以尝试一下 https://huggingface.co/FINAL-Bench/POCKET-Darwin-180B-GGUF

    按照 card 里面吹的,已经非常强悍了,但是查了一下,这是个 韩国 team ,所以,置信度要打折扣了。😂
    jinsongzhaocn
        7
    jinsongzhaocn  
       6h 18m ago
    @sentinelK 我认为以后跑分已经不具备参考意义了,有个混合精度的概念,把这个彻底打破了:不是把模型所有权重都简单地压缩到 2 位或 3 位,而是一种混合精度方案。比如,一个名为“Q2_K”的模型,其内部实际上可能混合了 Q4 、Q5 甚至 Q6 的精度。模型会把更大的比特宽度分配给对输出更“敏感”的层(如注意力机制的某些部分),而对不太敏感的层则使用更激进的压缩。因此,单纯用“Q2”来称呼它,会让人误以为整个模型都是极低精度,这掩盖了其内部精妙的混合设计,但是也为评分提供了超级作弊的手段。也就说实际效果,还是信大厂的标准模型最省心,各种奇技淫巧的尝试,最后都逃不掉全面平衡的设计。
    jinsongzhaocn
        8
    jinsongzhaocn  
       6h 8m ago
    补充一下,我这里只有 4090 卡,这个环境里,flash-next ,除了编程低于 27b, 其他都超过 27b,综合得分也超过 27b. 应该是策略没平衡好的一代,期待下一代所有评分都超过 27b 吧。除非一个例外就是 5090 以上高端卡+32GB 以上显存的环境,可以全面超过 27b.
    About   ·   Help   ·   Advertise   ·   Blog   ·   API   ·   FAQ   ·   Privacy   ·   Solana   ·   957 Online   Highest 6679   ·     Select Language
    创意工作者们的社区
    World is powered by solitude
    VERSION: 3.9.8.5 · 28ms · UTC 22:05 · PVG 06:05 · LAX 15:05 · JFK 18:05
    ♥ Do have faith in what you're doing.